معرفی
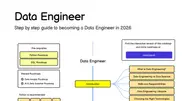
این نقشه راه شما را از مبانی کار با داده تا ساخت یک خط لوله داده قابل نگهداری پیش میبرد. مجموع زمان پیشنهادی گامهای این نقشه راه ۲۳۵ ساعت است، اما زمان واقعی تکمیل آن به دانش و تجربه قبلی شما بستگی دارد. اگر SQL و Python را در سطح پایه میدانید و هفتهای ۱۰ ساعت تمرین میکنید، برای تکمیل مسیر حدود ۱۵۰ تا ۲۵۰ ساعت، معادل ۴ تا ۶ ماه، در نظر بگیرید. اگر بدون پیشزمینه برنامهنویسی شروع میکنید، ممکن است به حدود ۲۴۰ تا ۴۸۰ ساعت، معادل ۶ تا ۱۲ ماه تمرین، نیاز داشته باشید.
ترتیب گامها عمدی است: ابتدا SQL و مدل داده را یاد میگیرید، سپس Python و مهندسی نرمافزار لازم برای خط لوله را اضافه میکنید. بعد از ساخت یک فرایند ETL یا ELT کوچک، سراغ زمانبندی، آزمون کیفیت و مشاهدهپذیری میروید. در پایان، با مفاهیم پردازش توزیعشده و پردازش جریانی آشنا میشوید تا بتوانید تشخیص دهید کدامیک از این روشها و ابزارهای مرتبط با آنها برای مسئله موردنظر لازم است.
برای تمرین پایه، یک مسیر عملی با SQL، Python، پایگاه داده رابطهای، Git و خط لوله دستهای انتخاب شده است. dbt و Apache Airflow در پروژه نهایی برای تمرین تبدیلهای مدلمحور و زمانبندی استفاده میشوند، اما آنها را نباید جایگزین مفاهیم مشترک مهندسی داده دانست. Apache Spark و Apache Kafka نیز برای همه موقعیتها پیشنیاز آغاز کار نیستند؛ آنها را زمانی عمیقتر تمرین کنید که مسئله یا آگهی هدف به پردازش حجیم، رویداد یا داده نزدیک به زمان واقعی نیاز دارد.
پیش از انتخاب ابزار پروژه، آگهی هدف را بررسی کنید. اگر آگهی بر Microsoft SQL Server و SSIS تمرکز دارد، مفاهیم ثابت مسیر شامل SQL، مدلسازی تحلیلی، بارگذاری افزایشی، کیفیت داده، زمانبندی و مستندسازی هستند. در این شاخه، میتوانید تمرینهای مبتنی بر PostgreSQL را با Microsoft SQL Server و تمرینهای مبتنی بر dbt را با پروژههای ETL در SSIS جایگزین کنید. اگر آگهی بر Python، dbt و Apache Airflow تمرکز دارد، مسیر اصلی این صفحه مناسبتر است. نکات ساخت رزومه و ارسال درخواست در راهنمای ورود مهندس داده و آمادگی برای گفتوگوهای استخدامی در راهنمای مصاحبه مهندس داده آمده است.
مخاطبان نقشه راه
این مسیر برای افرادی است که میخواهند از برنامهنویسی، تحلیل داده، مدیریت پایگاه داده یا رشتههای مرتبط وارد نقش مهندس داده شوند. اگر SQL یا Python پایه دارید، با سرعت بیشتری به پروژه نهایی میرسید. اگر تازهکار هستید، مسیر را با تمرین بیشتر در دو گام نخست آغاز کنید. نقطه شروع حداقلی، توانایی کار با رایانه و خواندن مستندات فنی انگلیسی است.
دستاورد پایانی
در پایان مسیر میتوانید یک خط لوله داده دستهای قابل اجرا بسازید: داده را از فایل، API یا پایگاه داده دریافت کنید، با SQL و Python تبدیل دهید، در یک مدل تحلیلی بارگذاری کنید، کیفیت آن را آزمون کنید و اجرای آن را زمانبندی و پایش کنید. همچنین میتوانید تفاوت نیازهای انبار داده، پردازش توزیعشده و جریان داده برخط را تشخیص دهید و برای موقعیتهای جونیور مهندس داده نمونهکار فنی قابل بررسی ارائه کنید.
پیشنیازها
موارد زیر پایههای لازم برای شروع را نشان میدهند.
- توانایی کار روزمره با رایانه و نصب نرمافزار
- انگلیسی فنی در حد خواندن مستندات و پیام خطا
- زمان ثابت برای تمرین و تکمیل پروژه
مسیر یادگیری شغل مهندس داده
-
۳۵ ساعت
مبانی داده، پایگاه داده و SQL
هدف گام: یاد بگیرید داده رابطهای را بخوانید، ترکیب کنید و با کوئریهای قابل اعتماد برای تحلیل یا تبدیل آماده کنید.
SQL یکی از مهمترین نقطههای شروع مهندسی داده است، زیرا بسیاری از خطوط لوله داده برای استخراج، تبدیل و بارگذاری اطلاعات با پایگاههای داده رابطهای کار میکنند. ابتدا مدل رابطهای، کلید اصلی و خارجی، نوع داده و تفاوت جدول عملیاتی با جدول تحلیلی را یاد بگیرید.
سپس روی SELECT، JOIN، GROUP BY، CTE، توابع پنجرهای و مدیریت مقدارهای NULL تمرین کنید. فقط به درست بودن خروجی اکتفا نکنید. بررسی کنید هر JOIN چرا انتخاب شده، آیا اتصال جدولها باعث افزایش ناخواسته تعداد رکوردها میشود و کوئری با افزایش حجم داده چه عملکردی خواهد داشت.
برای تمرین میتوانید PostgreSQL را انتخاب کنید. اگر آگهی هدف شما Microsoft SQL Server را میخواهد، همان تمرینها را با آن انجام دهید. تفاوتهای نحوی را جداگانه ثبت کنید، اما تمرکز اصلی را بر منطق SQL و مدل رابطهای نگه دارید.
مهارتها
ابزارها
مفاهیم تکمیلی
مدل رابطهای و یکپارچگی ارجاعیطراحی کلید اصلی و کلید خارجیاتصال جدولها با JOINتجمیع و گروهبندی دادهتوابع پنجرهای برای تحلیل رکوردهامدیریت مقدارهای NULL و داده تکراریخواندن طرحواره و وابستگی جدولهاپروژه پیشنهادی: یک پایگاه داده کوچک فروشگاهی در PostgreSQL یا Microsoft SQL Server بسازید که جدولهای مشتری، سفارش، آیتم سفارش و محصول داشته باشد. حداقل ۱۰ کوئری برای محاسبه فروش روزانه، مشتریان فعال، محصولات پرفروش و سفارشهای ناقص بنویسید.
معیار پایان گام: میتوانید یک پرسش کسبوکار را به SQL تبدیل کنید، چند جدول را بدون ایجاد شمارش تکراری به هم متصل کنید و علت انتخاب JOIN و منطق کوئری خود را توضیح دهید.
-
۳۵ ساعت
Python و مهندسی کد قابل نگهداری
هدف گام: برای دریافت، تبدیل و بارگذاری داده، اسکریپتهای Python خوانا، قابل آزمون و قابل تنظیم بنویسید.
در مهندسی داده، Python بیشتر برای اتصال به منبع داده، تبدیل رکوردها، کنترل خطا و ساخت اجزای خط لوله به کار میرود. روی ساختار دادهها، توابع، ماژولها، کار با فایلهای JSON و CSV، مدیریت خطا و ثبت رخدادها تمرکز کنید.
کد خط لوله را به یک فایل بلند تبدیل نکنید. تنظیمات اتصال، منطق استخراج، تبدیل و بارگذاری را جدا کنید. با Git تغییرات را ثبت کنید تا بتوانید یک خطای داده را به نسخه مشخصی از کد و تغییرات آن مرتبط کنید.
مهارتها
ابزارها
مفاهیم تکمیلی
ساختار داده و توابع در Pythonخواندن و نوشتن فایلهای JSON و CSVمدیریت خطا و ثبت رخدادهای اجرامدیریت تنظیمات و متغیرهای محیطیتقسیم کد به ماژولهای قابل نگهداریتست واحد برای تبدیلهای دادهثبت تغییرات و بازبینی کدپروژه پیشنهادی: اسکریپتی بسازید که یک فایل سفارش را بخواند، تاریخها و مبلغها را اعتبارسنجی کند، رکوردهای نامعتبر را در فایل جداگانه ثبت کند و خروجی پاکسازیشده تولید کند. برای حداقل سه حالت خطا تست بنویسید.
معیار پایان گام: میتوانید یک اسکریپت Python را به اجزای استخراج، تبدیل و بارگذاری تقسیم کنید، خطاهای قابل انتظار را مدیریت کنید و تغییرات پروژه را با Git ثبت کنید.
-
۳۰ ساعت
مدلسازی تحلیلی و طراحی انبار داده
هدف گام: داده عملیاتی را به جدولها و مدلهایی تبدیل کنید که برای گزارش و تحلیل پایدار و قابل فهم باشند.
جداول عملیاتی معمولاً برای اجرای تراکنش طراحی شدهاند، نه پاسخگویی ساده به پرسشهای تحلیلی. در این گام، ابتدا سطح دانهبندی هر جدول را روشن کنید؛ مثلاً هر سطر در جدول فروش نماینده یک سفارش است یا یک آیتم سفارش.
سپس ابعاد و واقعیتها، تاریخچه تغییرات و قرارداد نامگذاری را تمرین کنید. هدف، ساخت یک انبار داده بزرگ نیست. باید بتوانید مدلی طراحی کنید که تعریف شاخصها را روشن کند و تحلیلگر بتواند بدون نیاز به اتصالهای پیچیده یا مبهم از آن استفاده کند.
مهارتها
ابزارها
مفاهیم تکمیلی
- تعیین دانهبندی جدول تحلیلی
- مدل ستارهای و نقش جدولهای واقعیت و بُعد
- مدیریت ابعاد با تغییرات تاریخی
- تعریف شاخص و قرارداد معنایی داده
- لایهبندی داده خام، میانی و مصرفی
- نامگذاری مدلها و ستونهای تحلیلی
پروژه پیشنهادی: داده عملیاتی فروشگاه گام اول را به یک مدل تحلیلی شامل جدول واقعیت فروش و ابعاد مشتری، محصول و تاریخ تبدیل کنید. برای سه شاخص مانند فروش خالص، تعداد سفارش و مشتری بازگشتی، تعریف مکتوب بنویسید.
معیار پایان گام: میتوانید دانهبندی یک جدول را پیش از ساخت آن تعیین کنید، مدل ستارهای ساده طراحی کنید و تفاوت داده خام، مدل میانی و جدول مصرفی را توضیح دهید.
-
۳۵ ساعت
ساخت خط لوله دستهای ETL و ELT
هدف گام: یک جریان تکرارپذیر برای استخراج، تبدیل و بارگذاری داده از منابع مختلف طراحی کنید.
اکنون SQL، Python و مدلسازی را در یک خط لوله واقعی کنار هم قرار دهید. داده را از یک API عمومی، فایل یا پایگاه داده مبدأ دریافت کنید، اعتبار اولیه انجام دهید و آن را در لایه خام ذخیره کنید. سپس تبدیلها را بهگونهای اجرا کنید که اجرای دوباره، داده را خراب یا تکراری نکند.
در فرایند ELT، ابزار dbt برای سازماندهی مدلهای SQL، مدیریت وابستگی میان مدلها و اجرای آزمونهای داده مناسب است. ETL زمانی کاربرد دارد که باید پیش از بارگذاری تبدیل انجام دهید یا محدودیت منبع و مقصد چنین تصمیمی را ایجاب میکند. انتخاب را بر اساس مسئله انجام دهید، نه صرفاً ابزار محبوب.
اگر مسیر شغلی هدف شما بر Microsoft SQL Server و SSIS تکیه دارد، همان اصول استخراج، بارگذاری افزایشی، ثبت وضعیت اجرا و جلوگیری از داده تکراری را در یک بسته SSIS تمرین کنید. در این حالت، میتوانید دادهها را در Microsoft SQL Server ذخیره کنید و تبدیلها، کنترل جریان اجرا و مدیریت خطا را با قابلیتهای SSIS پیادهسازی کنید.
مهارتها
طراحی و توسعه خطوط لوله دادهمهندسی دادهپاکسازی و آمادهسازی دادهیکپارچهسازی APIپایگاه داده و SQLبرنامهنویسی پایتونابزارها
مفاهیم تکمیلی
- استخراج داده از API و فایل
- بارگذاری افزایشی و جلوگیری از داده تکراری
- طراحی اجرای تکرارپذیر خط لوله
- تفاوت ETL و ELT در عمل
- مدلهای تبدیل و وابستگی میان آنها
- مدیریت تغییر ساختار داده مبدأ
- ثبت وضعیت اجرای هر بارگذاری
- طراحی بسته ETL با SSIS
پروژه پیشنهادی: یک خط لوله بسازید که داده را از یک API عمومی یا فایل CSV دریافت کند، در PostgreSQL بارگذاری کند، با dbt به مدل تحلیلی تبدیل کند و فقط رکوردهای جدید یا تغییرکرده را پردازش کند. در شاخه Microsoft SQL Server، همین مسئله را با Microsoft SQL Server و یک بسته SSIS پیادهسازی کنید.
معیار پایان گام: خط لوله شما با اجرای دوباره داده تکراری تولید نمیکند، خطاهای اصلی را ثبت میکند و خروجی آن حداقل یک جدول تحلیلی قابل پرسوجو است. اگر از SSIS استفاده میکنید، بتوانید جریان داده و منطق بارگذاری افزایشی بسته را توضیح دهید.
-
۳۰ ساعت
زمانبندی، کیفیت و مشاهدهپذیری داده
هدف گام: خط لوله را از یک اسکریپت دستی به فرایندی زمانبندیشده، قابل آزمون و قابل پیگیری تبدیل کنید.
یک خط لوله وقتی برای کار تیمی مناسب است که شکست آن دیده شود و علت شکست قابل پیگیری باشد. با Apache Airflow وابستگی میان وظایف، زمانبندی اجرا، تلاش مجدد پس از شکست و مدیریت وضعیت وظایف را پیادهسازی کنید. ابتدا یک جریان کوچک بسازید و پیچیدگیهای غیرضروری مانند چندین DAG وابسته را به پروژه تحمیل نکنید.
کیفیت داده را فقط با موفق شدن اجرای برنامه نسنجید. آزمونهایی برای یکتایی شناسه، کامل بودن ستونهای ضروری، تازگی داده و محدوده قابل قبول مقدارها تعریف کنید. هر آزمون باید به یک فرض مشخص درباره داده متصل باشد.
در مسیر مبتنی بر Microsoft SQL Server و SSIS، زمانبندی بستهها را با سازوکارهای موجود در محیط سازمانی، مانند SQL Server Agent، تمرین کنید و گزارش اجرای بستهها را بررسی کنید. اصل ثابت این است که بتوانید شکست اجرا، تلاش مجدد و نتیجه آزمون کیفیت را پیگیری کنید، نه اینکه صرفاً کار با یک ابزار مشخص را یاد گرفته باشید.
مهارتها
تضمین کیفیت و مشاهدهپذیری دادهطراحی و توسعه خطوط لوله دادهپایش و مشاهدهپذیری سامانههاتست نرمافزارابزارها
مفاهیم تکمیلی
زمانبندی و وابستگی وظایف خط لولهاجرای مجدد و بازیابی پس از شکستآزمون یکتایی و کامل بودن دادهسنجش تازگی و تأخیر دادهثبت وضعیت و زمان اجرای وظایفهشدار برای شکست و تأخیر خط لولهریشهیابی اختلاف میان منبع و خروجیبررسی گزارش اجرای بسته SSISپروژه پیشنهادی: خط لوله گام قبل را با Apache Airflow زمانبندی کنید. برای مدلهای dbt آزمون یکتایی و مقدار تهی اضافه کنید و سناریوی شکست یک منبع داده را طوری شبیهسازی کنید که اجرای ناموفق و علت آن قابل مشاهده باشد. در شاخه SSIS، یک اجرای ناموفق را ثبت کنید، علت خطا را بررسی کنید و روند اجرای مجدد یا بازیابی بسته را مستند کنید.
معیار پایان گام: در مسیر Apache Airflow میتوانید یک DAG دارای وظایف وابسته بسازید، شکست یک وظیفه را تشخیص دهید، اجرای مجدد آن را مدیریت کنید و حداقل چهار آزمون کیفیت داده داشته باشید. در مسیر SSIS نیز میتوانید وضعیت اجرای بسته، علت شکست و نتیجه بازیابی آن را پیگیری کنید.
-
۲۰ ساعت
پردازش توزیعشده با Apache Spark
هدف گام: تشخیص دهید چه زمانی پردازش توزیعشده لازم است و یک تبدیل داده حجیم را با Apache Spark پیادهسازی کنید.
Apache Spark برای هر پروژه دادهای ضروری نیست. ابتدا بدانید چرا یک پردازش محلی یا SQL معمولی پاسخگو نیست: حجم داده، زمان اجرا یا نیاز به پردازش موازی باید دلیل مشخصی داشته باشد. سپس مفاهیم پارتیشن، جابهجایی داده میان گرهها، تبدیلهای تنبل و تفاوت عملیات تبدیل و تجمیع را تمرین کنید.
روی خوانایی و درستی منطق داده مقدم بر بهینهسازی زودهنگام تمرکز کنید. برای پروژه تمرینی، دادهای با حجم قابل مدیریت کافی است؛ هدف نشان دادن فهم معماری و تصمیمهای پردازش است، نه ساختن خوشه پرهزینه.
مهارتها
ابزارها
مفاهیم تکمیلی
پارتیشنبندی داده در پردازش توزیعشدهتبدیل و تجمیع در پردازش موازیهزینه جابهجایی داده میان گرههامدیریت طرحواره دادههای حجیمانتخاب اندازه مناسب پارتیشنتشخیص گلوگاههای اجرای پردازشپروژه پیشنهادی: یک مجموعه داده رویدادی یا تراکنشی نسبتاً بزرگ را با Apache Spark بخوانید، پاکسازی و تجمیع کنید و نتیجه را در قالب جدول تحلیلی ذخیره کنید. در مستندات توضیح دهید چرا Spark برای این سناریو انتخاب شده است.
معیار پایان گام: میتوانید تفاوت پردازش محلی و توزیعشده را توضیح دهید، یک تبدیل Spark با طرحواره مشخص اجرا کنید و حداقل یک گلوگاه احتمالی در پارتیشنبندی یا تجمیع را شناسایی کنید.
-
۲۰ ساعت
مبانی جریان داده برخط با Apache Kafka
هدف گام: مفاهیم کلیدی داده جریانی را یاد بگیرید و یک جریان رویداد ساده را با توجه به خطا و تکرار پیام طراحی کنید.
پردازش جریانی با اجرای سریعتر یک ETL دستهای تفاوت دارد. باید درباره تأخیر، ترتیب پیام، تکرار، نگهداری پیام و بازیابی مصرفکننده تصمیم بگیرید. Apache Kafka را با مفاهیم تولیدکننده، مصرفکننده، موضوع (Topic)، پارتیشن (Partition) و گروه مصرفکننده (Consumer Group) یاد بگیرید.
این گام برای آگهیهایی اهمیت بیشتری دارد که داده نزدیک به زمان واقعی، رخدادهای محصول یا یکپارچهسازی سرویسها را ذکر میکنند. اگر هدف شما نقشهای متمرکز بر انبار داده است، درک مفاهیم و تکمیل پروژه کوچک کافی است؛ تمرین عمیقتر را بر اساس نیاز آگهی انتخاب کنید.
مهارتها
ابزارها
مفاهیم تکمیلی
تولیدکننده و مصرفکننده رویدادtopic و پارتیشنبندی پیامهاگروه مصرفکننده و مقیاسپذیریمدیریت تکرار و ترتیب پیامهاثبت offset و بازیابی مصرفکنندهتفاوت پردازش دستهای و جریانیطراحی قرارداد رویدادپروژه پیشنهادی: یک تولیدکننده رویداد سفارش و یک مصرفکننده بسازید که رویدادها را از Apache Kafka دریافت کند، پیامهای تکراری را تشخیص دهد و خروجی خلاصه را در PostgreSQL ذخیره کند.
معیار پایان گام: میتوانید نقش topic، partition و consumer group را توضیح دهید، یک تولیدکننده و مصرفکننده ساده اجرا کنید و برای تکرار پیام راهکار مشخص داشته باشید.
-
۳۰ ساعت
پروژه نهایی و مستندسازی سامانه داده
هدف گام: تواناییهای مسیر را در یک پروژه قابل اجرا، قابل بررسی و نزدیک به مسئله واقعی یکپارچه کنید.
پروژه نهایی باید یک مسئله روشن داشته باشد؛ مثلاً ساخت لایه تحلیلی برای سفارشهای یک فروشگاه آنلاین یا پردازش رویدادهای رفتار کاربر. منبع داده، دانهبندی مدلها، منطق تبدیل، زمانبندی، آزمونهای کیفیت و شیوه بازیابی از خطا را مستند کنید.
مخزن پروژه را طوری آماده کنید که فرد دیگری بتواند آن را اجرا و ارزیابی کند: راهنمای نصب، متغیرهای محیطی نمونه، نمودار ساده جریان داده، داده نمونه و توضیح محدودیتها را اضافه کنید. این یک پروژه یکپارچه، با کیفیت فنی و مستندات کافی، برای نشان دادن آمادگی اولیه از مجموعهای از تمرینهای پراکنده مفیدتر است.
مهارتها
مهندسی دادهطراحی و توسعه خطوط لوله دادهطراحی و توسعه انبار دادهتضمین کیفیت و مشاهدهپذیری دادهارتباطات فنیکنترل نسخهابزارها
مفاهیم تکمیلی
مستندسازی منبع و مالک دادهترسیم جریان داده و وابستگیهاطراحی قرارداد داده میان سامانههامدیریت تنظیمات اجرای پروژهثبت فرضها و محدودیتهای پروژهبازبینی تغییرات مدل دادهراهنمای اجرای تکرارپذیر پروژهپروژه پیشنهادی: در مسیر مبتنی بر PostgreSQL، یک پروژه کامل بسازید که داده را از API یا فایل دریافت کند، در PostgreSQL بارگذاری کند، با dbt مدل تحلیلی بسازد، با Apache Airflow زمانبندی شود و آزمونهای کیفیت داده داشته باشد. در مسیر مبتنی بر Microsoft SQL Server نیز همین مسئله را با استفاده از SQL Server و SSIS پیادهسازی کنید و روش زمانبندی، ثبت وضعیت اجرا و کنترل کیفیت داده را مستند کنید. مخزن Git باید راهنمای اجرا، نمودار جریان داده و توضیح تصمیمهای فنی را شامل شود.
معیار پایان گام: فرد دیگری میتواند با خواندن فایل README، پروژه را اجرا کند، خروجی تحلیلی را ببیند، آزمونهای کیفیت را اجرا کند و مسیر داده را از منبع تا جدول نهایی دنبال کند.
زمان تقریبی یادگیری
برآورد مجموع زمان آموزش، مطالعه و تمرین تا رسیدن به سطح کاربردی؛ بسته به پیشزمینه شما میتواند کمتر یا بیشتر باشد.
ابزارهای مسیر
در ادامه، مهمترین موارد این بخش به تفکیک معرفی شدهاند.
- ابزار پایتون Python
- ابزار پستگرسکیوال PostgreSQL
- ابزار مایکروسافت اسکیوال سرور Microsoft SQL Server
- ابزار گیت Git
- ابزار پایتست pytest
- ابزار دیبیتی (dbt) dbt
- ابزار اسکیوال سرور اینتگریشن سرویسز (SSIS) SQL Server Integration Services (SSIS)
- ابزار آپاچی ایرفلو Apache Airflow
- ابزار آپاچی اسپارک Apache Spark
- ابزار آپاچی کافکا Apache Kafka
خطاهای رایج مسیر
موارد زیر تصویری کلی از این بخش برای این مسیر ارائه میکنند.
-
شروع همزمان با Spark، Kafka و چند ابزار ابری
ابتدا SQL، Python، مدلسازی و یک خط لوله دستهای را کامل کنید. Spark و Kafka را فقط پس از فهم مسئلهای یاد بگیرید که پردازش توزیعشده یا جریان برخط را توجیه میکند.
-
ساختن خط لولهای که با اجرای دوباره داده تکراری تولید میکند
از ابتدا برای اجرای تکرارپذیر طراحی کنید. کلید یکتا، ثبت وضعیت بارگذاری، بارگذاری افزایشی و رفتار مشخص در برابر داده تکراری را در پروژه آزمایش کنید.
-
نادیده گرفتن دانهبندی جدولها
پیش از نوشتن مدل یا کوئری، بنویسید هر سطر نماینده چیست. سپس بررسی کنید JOINها شمارش را تغییر نمیدهند و شاخصها با همان دانهبندی محاسبه میشوند.
-
سنجش موفقیت فقط با اجرای بدون خطای برنامه
برای یکتایی، مقدار تهی، تازگی و محدوده مقادیر آزمون تعریف کنید. اجرای موفق خط لوله تضمین نمیکند که داده خروجی درست یا کامل است.
-
استفاده از داده واقعی یا اطلاعات حساس در نمونهکار عمومی
داده عمومی، ساختگی یا ناشناسسازیشده استفاده کنید. کلید دسترسی، رمز عبور، نشانی داخلی و داده شخصی را در مخزن Git قرار ندهید.
-
نوشتن پروژه بدون مستندات منبع و منطق تبدیل
README را بخشی از پروژه بدانید. منبع داده، ساختار پوشهها، شیوه اجرا، مدلها، آزمونها، محدودیتها و تصمیمهای اصلی را مستند کنید.
-
کپی کردن کوئری یا DAG بدون فهم وابستگیها
هر بخش را با داده نمونه تغییر دهید و اثر آن را بررسی کنید. بتوانید توضیح دهید هر وظیفه چه ورودی و خروجی دارد و در صورت شکست چه اتفاقی میافتد.
چکلیست آمادگی شغلی
چکلیست زیر کمک میکند هیچ نکته مهمی را از قلم نیندازید:
- میتوانم با SQL شامل JOIN، CTE و توابع پنجرهای، داده چند جدول را درست تحلیل یا تبدیل کنم.
- میتوانم دانهبندی جدول و تفاوت جدول واقعیت و بُعد را برای یک مسئله تحلیلی تعیین کنم.
- میتوانم با Python داده را از فایل یا API دریافت، اعتبارسنجی و بارگذاری کنم.
- میتوانم یک خط لوله افزایشی بسازم که با اجرای دوباره داده تکراری تولید نکند.
- در مسیر مبتنی بر PostgreSQL میتوانم مدلهای تحلیلی SQL را با dbt سازماندهی و برای آنها آزمون تعریف کنم.
- میتوانم یک جریان داده را با Apache Airflow زمانبندی کنم و شکست اجرای آن را پیگیری کنم.
- میتوانم برای کیفیت داده آزمون یکتایی، کامل بودن و تازگی تعریف کنم.
- میتوانم تفاوت کاربرد Apache Spark و Apache Kafka با خط لوله دستهای معمولی را توضیح دهم.
- میتوانم یک پروژه مهندسی داده قابل اجرا با README، تنظیمات نمونه و نمودار جریان داده در Git ارائه کنم.
پرسشهای پرتکرار
در این بخش، به تعدادی از پرسشهای رایج درباره این مسیر پاسخ داده شده است.
برای شروع مهندسی داده SQL مهمتر است یا Python؟
هر دو لازماند، اما SQL معمولاً نقطه شروع مناسبتری است؛ زیرا فهم جدولها، اتصال داده و مدلسازی را شکل میدهد. پس از تسلط کاربردی بر SQL، Python را برای خودکارسازی استخراج، تبدیل و کنترل خطا اضافه کنید.
تکمیل این نقشه راه چقدر زمان میبرد؟
اگر SQL و Python پایه دارید و هفتهای حدود ۱۰ ساعت تمرین میکنید، معمولاً ۱۵۰ تا ۲۵۰ ساعت، حدود ۴ تا ۶ ماه، زمان نیاز دارید. اگر بدون پیشزمینه برنامهنویسی شروع میکنید، حدود ۲۴۰ تا ۴۸۰ ساعت، معادل ۶ تا ۱۲ ماه با همین زمان هفتگی، برای یادگیری و تمرین در نظر بگیرید.
آیا باید همه ابزارهای این نقشه راه را در سطح حرفهای یاد بگیرم؟
خیر. برای ورود، SQL، Python، یک پایگاه داده رابطهای، Git، مدلسازی و ساخت خط لوله دستهای اولویت دارند. Spark و Kafka را در حد مفهومی و پروژه کوچک یاد بگیرید، مگر اینکه آگهیهای هدف شما صریحاً تجربه عمیقتری از آنها بخواهند.
برای پروژه نهایی مهندسی داده چه چیزی بسازم؟
یک پروژه یکپارچه بسازید که دریافت داده، تبدیل، مدلسازی، آزمون کیفیت، زمانبندی و مستندات اجرا را نشان دهد. جزئیات آمادهسازی نمونهکار برای استخدام در راهنمای ورود مهندس داده آمده است.
آیا dbt جای Python یا Apache Airflow را میگیرد؟
خیر. dbt بیشتر برای سازماندهی تبدیلهای داده در مقصد، مدلهای SQL و آزمونها کاربرد دارد. Python برای منطق استخراج و پردازشهای لازم و Apache Airflow برای زمانبندی و هماهنگی وظایف استفاده میشوند؛ البته مرز دقیق ابزارها به معماری تیم بستگی دارد.
اگر هدفم کار با Microsoft SQL Server است، باید PostgreSQL یاد بگیرم؟
مفاهیم SQL، مدلسازی و طراحی خط لوله میان پایگاههای داده رابطهای تا حد زیادی مشترکاند. میتوانید تمرینهای این مسیر را با Microsoft SQL Server انجام دهید و در صورت نیاز آگهی هدف، پروژه ETL را با SSIS بسازید. PostgreSQL در این نقشه راه یک محیط تمرینی است، نه الزام شغلی.
آیا مدرک دانشگاهی یا گواهی رسمی برای ورود لازم است؟
شرایط تحصیلی و گواهیهای مورد نیاز به کارفرما و موقعیت شغلی بستگی دارد. برخی آگهیها مدرک دانشگاهی مرتبط را شرط میدانند، درحالیکه برخی دیگر بیشتر بر مهارت فنی، تجربه عملی و نمونهکار تمرکز میکنند. بهتر است شرایط هر موقعیت را جداگانه بررسی کنید.
آموزشهای مرتبط در فرادرس
-
 آموزش اصول مهندسی داده، مبانی تا امنیت و حریم خصوصی
-
 آموزش فرایند ETL و ساخت انبار داده با ابزار SSIS در SQL
-
 آموزش اس کیو ال سرور SQL Server + مثالهای عملی، مقدماتی + گواهینامه
-
 آموزش اس کیو ال سرور SQL Server، پیشرفته + گواهینامه
-
 آموزش برنامه نویسی پایتون Python، مقدماتی + گواهینامه
-
 آموزش برنامه نویسی پایتون پیشرفته، ترفندهای Python + گواهینامه
-
 آموزش تجزیه و تحلیل و آماده سازی داده ها با پایتون Python + گواهینامه
-
 Generator در پایتون چیست؟، به زبان ساده + سینتکس و مثال جنریتور